Message suspect : les vérifications à faire avant de cliquer ou de répondre
Un message inattendu peut imiter une communication habituelle tout en vous poussant à agir vite. Examinez l’expéditeur, la demande et l’adresse du…
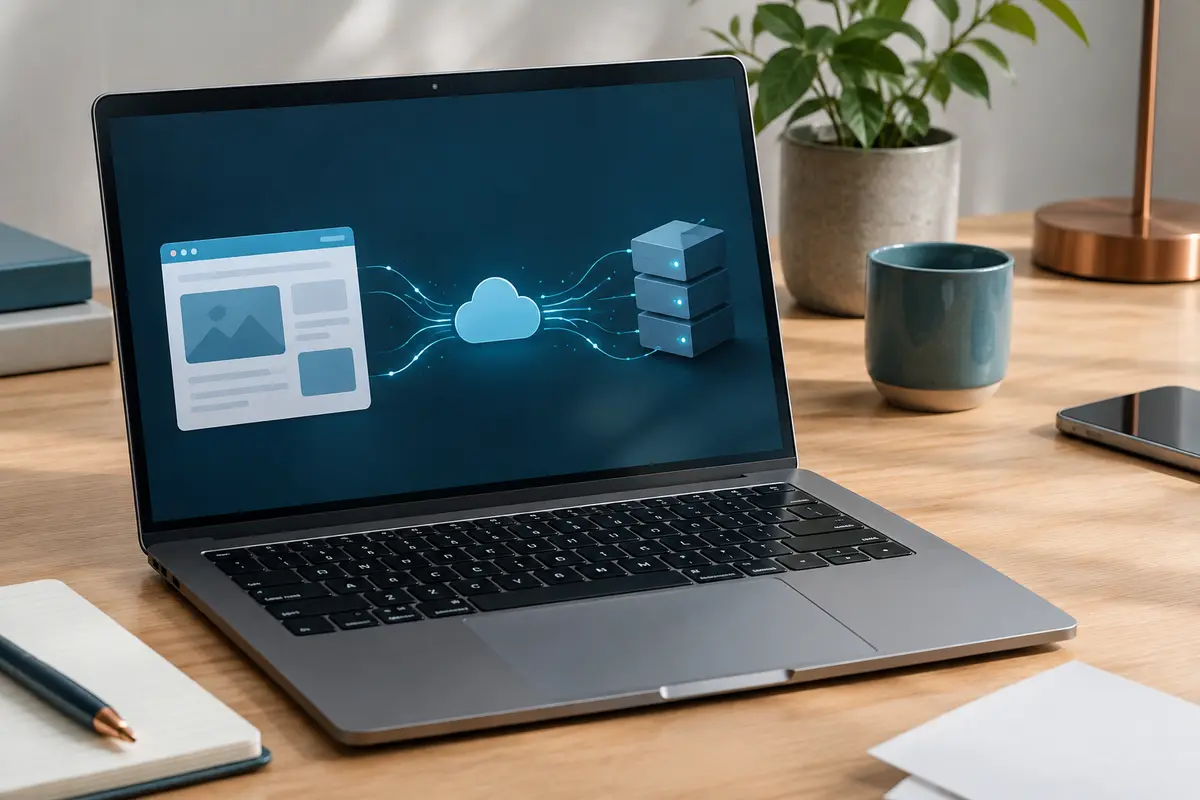
Quand vous saisissez une adresse web, le navigateur l’interprète, cherche le serveur correspondant, puis lui demande la page. Il reçoit des éléments qu’il assemble pour afficher le contenu, tandis que des échanges et des vérifications restent invisibles.
Quand vous saisissez une adresse web, le navigateur ne se contente pas d’ouvrir un document déjà prêt. Il interprète l’adresse, localise le service qui héberge le site, établit une communication et récupère les éléments nécessaires à l’affichage. Comprendre ce trajet aide à distinguer un problème de réseau d’une page indisponible ou d’un contenu qui tarde à apparaître.
Ces opérations s’enchaînent rapidement, parfois en partie grâce à des informations déjà conservées sur votre appareil. Voici le rôle de chaque étape, de la barre d’adresse jusqu’au rendu visible à l’écran.
Une adresse web contient des indications qui orientent le navigateur. Elle peut préciser le protocole de communication, le nom de domaine du site, un chemin vers une ressource et des paramètres associés à la demande. Le navigateur sépare ces éléments pour savoir où se connecter et quel contenu réclamer.
Le chemin peut désigner une page précise ou une ressource, tandis que des paramètres peuvent transmettre des informations utiles au fonctionnement du site. La partie qui suit le signe dièse, appelée fragment, sert généralement à viser une section de la page ou à transmettre un repère à une application web. Elle n’est normalement pas envoyée au serveur dans la requête habituelle.
La barre d’adresse peut aussi recevoir des mots plutôt qu’une adresse complète. Dans ce cas, le navigateur peut les interpréter comme une recherche. Il complète parfois une adresse incomplète en choisissant un protocole ou en proposant une destination, selon ses réglages. Une faute dans le nom de domaine peut donc conduire ailleurs ou empêcher la navigation.
Les personnes retiennent plus facilement un nom de domaine qu’une adresse technique. Pour joindre le service, le navigateur a besoin d’une adresse IP, c’est‑à‑dire d’une information permettant d’acheminer les échanges sur le réseau. Le système DNS aide à associer le nom demandé à une adresse utilisable.
Cette recherche ne recommence pas nécessairement à chaque visite. Le navigateur, l’appareil ou un service réseau peut avoir conservé une réponse en cache. Si l’information manque ou n’est plus utilisable, une demande DNS est transmise à un résolveur, qui recherche la réponse et la renvoie. Le parcours exact dépend de la configuration du réseau et des informations déjà disponibles.
Le nom demandé peut conduire à une infrastructure qui distribue le contenu plutôt qu’à un serveur unique. Le navigateur n’a pas besoin de connaître l’organisation interne du site : il lui suffit d’obtenir les informations nécessaires pour joindre le service. Si la résolution échoue, la page ne peut pas être demandée, même si le navigateur fonctionne normalement.
Une fois l’adresse réseau connue, le navigateur tente de communiquer avec le service. Selon le protocole utilisé et les capacités des deux côtés, la connexion peut s’appuyer sur des mécanismes de transport différents. Dans certains cas, le navigateur peut aussi réutiliser une connexion déjà ouverte, ce qui évite de recommencer toutes les négociations.
Pour une adresse en HTTPS, une négociation de sécurité précède l’échange du contenu. Le navigateur et le serveur mettent en place un canal chiffré, puis le navigateur vérifie le certificat présenté pour s’assurer qu’il correspond au site demandé et qu’il est valide. En cas d’anomalie, un avertissement peut apparaître et la connexion peut être interrompue ou limitée.
Le chiffrement protège les données échangées contre leur lecture par des tiers sur le trajet. Il ne garantit pas, à lui seul, que le site est honnête, que ses informations sont exactes ou que les fichiers reçus sont inoffensifs. Il indique surtout que la communication avec le site est protégée selon les vérifications effectuées par le navigateur.
Lorsque la communication est prête, le navigateur envoie une requête. Celle‑ci indique notamment la ressource souhaitée et le type de réponse que le logiciel sait traiter. Elle peut aussi contenir des préférences, des informations de langue ou des cookies associés au site, si les règles applicables à ces cookies le permettent.
Le serveur traite la demande et renvoie une réponse. Celle‑ci comporte des informations de contrôle, comme un statut, ainsi qu’un contenu éventuel. Une réponse peut fournir la page demandée, signaler une redirection vers une autre adresse ou indiquer que la ressource n’est pas disponible. Le navigateur adapte alors son comportement à la réponse reçue.
La page principale est souvent un document HTML, qui décrit la structure du contenu. Mais ce document ne suffit pas toujours à produire l’affichage complet. Il peut référencer des feuilles de style pour la mise en forme, des images, des polices et des scripts. Le navigateur réclame ces ressources au fil de leur découverte, parfois en parallèle, et peut recevoir des contenus supplémentaires générés par le site.
Une page web n’est donc pas nécessairement un fichier unique transféré d’un seul coup. Des éléments peuvent provenir de services différents ou être chargés seulement lorsqu’ils deviennent utiles. C’est pourquoi le texte peut apparaître avant certaines images, et pourquoi une partie de la page peut rester disponible alors qu’un autre élément ne s’affiche pas.
Le navigateur analyse le HTML et construit une représentation de la structure de la page. Il lit aussi les règles de style, qui définissent l’apparence et la disposition des éléments. À partir de ces informations, il calcule où placer les contenus et comment les présenter selon la taille de la fenêtre et les capacités de l’appareil.
Les scripts peuvent modifier la page après son arrivée. Ils servent notamment à rendre certains éléments interactifs, à actualiser des contenus ou à demander des données complémentaires. Leur exécution peut donc déclencher de nouveaux échanges avec des serveurs. Si un script nécessaire ne fonctionne pas, la page peut apparaître incomplète ou certaines commandes peuvent rester inactives, même si le document principal a bien été reçu.
Le navigateur dessine ensuite les éléments visibles à l’écran. Ce rendu peut se faire progressivement : le contenu disponible s’affiche pendant que d’autres ressources sont encore récupérées ou traitées. Une modification de taille de fenêtre, l’arrivée d’une police ou l’ajout de contenu peut entraîner un nouveau calcul de la mise en page.
Le cache joue aussi un rôle à cette étape et lors des visites suivantes. Il peut conserver des ressources pour éviter de les télécharger à nouveau, ou demander au serveur si une copie locale reste à jour. Cela ne signifie pas que toute une page est disponible hors ligne : certains contenus dépendent de données ou de fonctions qui nécessitent une connexion active.
Une page qui tarde à s’afficher peut être ralentie à différentes étapes : la recherche DNS, l’établissement de la connexion, le traitement de la demande par le serveur, le transfert des ressources ou leur traitement par le navigateur. Une connexion lente n’est donc pas la seule explication possible. Des scripts lourds, des images volumineuses ou un appareil très sollicité peuvent aussi retarder le rendu.
Pour comprendre le problème, vérifiez d’abord que l’adresse est correctement saisie et observez le message affiché par le navigateur. Si le site s’ouvre mais semble incomplet, recharger la page peut parfois relancer les demandes. Si seule une adresse pose problème, l’origine est probablement différente d’une panne qui affecte toutes les pages.
Retenez surtout que l’affichage résulte d’une chaîne d’opérations distinctes. Le navigateur interprète l’adresse, trouve un service, échange des données, puis transforme les réponses reçues en contenu visible. Cette distinction permet de mieux comprendre pourquoi une page peut être inaccessible, lente ou seulement partiellement affichée.
Le navigateur peut afficher le contenu qu’il a déjà reçu pendant qu’il télécharge ou traite d’autres ressources. Les images, les styles ou les scripts peuvent arriver à des moments différents.
Non. HTTPS protège la communication et permet au navigateur de vérifier le certificat présenté pour le site. Cela ne garantit ni l’honnêteté du site ni l’exactitude de son contenu.
Le navigateur peut réutiliser des ressources conservées en cache ou une connexion déjà établie. Certains contenus dépendent toutefois d’échanges avec le serveur et doivent être récupérés à nouveau.
Les prix indiqués sont ceux constatés à la date mentionnée ; seul le prix affiché lors de la commande fait foi.
Un message inattendu peut imiter une communication habituelle tout en vous poussant à agir vite. Examinez l’expéditeur, la demande et l’adresse du…
Désinstaller une application retire le logiciel de l’appareil, mais ne supprime pas forcément le compte ni les données conservées en ligne. Pour…
Pendant les réunions d’hiver, les photos prises par les proches s’éparpillent vite entre téléphones et conversations. Un espace commun, un…
La mémoire vive aide votre appareil à faire fonctionner les tâches en cours, tandis que le stockage conserve les fichiers et les applications.